Os indivíduos de uma espécie podem estar distribuídos no espaço de forma aleatória, regular (uniforme) ou agregada. Com dados de inventário em parcelas de área fixa, esse padrão pode ser estimado por índices de agregação, que comparam o número de árvores por parcela com o esperado se a distribuição fosse aleatória.
O que todos os índices precisam é de uma tabela com quantas árvores de cada espécie há em cada parcela.
Roteiro da aula prática (02/10 · EE3)
Preparar o RStudio e importar os dados caixeta (seção 0 e 1);
Calcular à mão, no R, os índices para uma espécie, passo a passo (seção 2);
Repetir para outra espécie, sozinho(a) (Sua vez!);
Automatizar o cálculo para todas as espécies e interpretar (seções 3 a 5);
Responder aos exercícios (seção 6).
0. Antes de começar
Abra o RStudio e crie um projeto: File → New Project → New Directory → New Project, com o nome pratica_agregacao.
Dentro da pasta do projeto, crie uma pasta dados/ e salve nela o arquivo caixeta.csv.
Crie um script novo (File → New File → R Script), salve como agregacao.R e vá copiando os blocos de código desta página. Use o botão de copiar no canto de cada bloco.
Nesta prática usamos apenas o R básico: não é preciso instalar pacotes.
1. Dados: os caixetais do Vale do Ribeira
Usamos o conjunto de dados caixeta, do curso Ecologia de Comunidades no R (ecoR/USP). Os dados vêm da dissertação de mestrado de Andrea Vanin (1999) sobre os caixetais, florestas paludosas de restinga dominadas pela caixeta (Tabebuia cassinoides), em três locais do Vale do Ribeira (SP): chauas, jureia e retiro. Em cada local foram instaladas 5 parcelas de 10 × 20 m.
Coluna
Descrição
local
caixetal (3 locais)
parcela
número da parcela (repete-se entre os locais)
arvore
número da árvore na parcela
fuste
número do fuste (uma árvore pode ter vários)
cap
circunferência à altura do peito (1,3 m)
h
altura do fuste mais alto
especie
nome da espécie
cx <-read.csv("../dados/caixeta.csv") # no seu projeto: read.csv("dados/caixeta.csv")str(cx)
Cada linha da planilha é um fuste. Para os índices, precisamos contar árvores, então ficamos com uma linha por árvore. Como os números das parcelas e das árvores se repetem entre os locais, criamos também um código único de parcela:
# corrige uma grafia duplicada (veja a rotina de nomes científicos!)cx$especie[cx$especie =="Callophyllum brasiliensis"] <-"Calophyllum brasiliensis"arv <-unique(cx[, c("local", "parcela", "arvore", "especie")])arv$parc <-paste(arv$local, arv$parcela, sep ="_")c(fustes =nrow(cx), arvores =nrow(arv), parcelas =length(unique(arv$parc)))
  fustes  arvores parcelas
    1027      672       15
Tabela espécie × parcela
O que todos os índices precisam é de uma tabela com quantas árvores de cada espécie há em cada parcela:
Repare em nomes como Mela 1 (morfoespécie), Psidium sp (identificada só até gênero) e jussara (nome popular da palmeira Euterpe edulis). Numa análise real, esses nomes devem ser padronizados antes, como mostramos na rotina de padronização de nomes científicos.
Parcelas vazias também contam! Se uma parcela não tiver nenhum indivíduo de nenhuma espécie, ela não aparece na tabela. Nesse caso, informe UT manualmente com o número real de parcelas e acrescente colunas de zeros.
2. Passo a passo com uma espécie
Antes de automatizar, vamos calcular cada índice “à mão” para Myrcia sulfiflora. Assim fica claro de onde vem cada número.
Os dados da espécie
n_ij <- tab["Myrcia sulfiflora", ] # nº de árvores da espécie em cada parcelan_ij
n_i <-sum(n_ij)U_i <-sum(n_ij >0)M_i <-mean(n_ij)S2 <-var(n_ij) # o R já usa (UT - 1) no denominadorc(UT = UT, n_i = n_i, U_i = U_i, M_i = M_i, S2 = S2)
       UT       n_i       U_i       M_i        S2
15.000000 79.000000  5.000000  5.266667 69.638095
Índice de MacGuinnes (\(IGA_i\))
Compara a densidade observada com a esperada se a distribuição fosse aleatória:
D_i <- n_i / UTd_i <--log(1- U_i / UT) # log() no R é o logaritmo natural (ln)IGA <- D_i / d_ic(D_i = D_i, d_i = d_i, IGA = IGA)
       D_i        d_i        IGA
 5.2666667  0.4054651 12.9891982
Interpretação:\(IGA_i\) < 1 uniforme; = 1 aleatório; entre 1 e 2 tendência ao agrupamento; > 2 agregado.
Índice de Fracker e Brischle (\(K_i\))
\[K_i = \frac{D_i - d_i}{d_i^2}\]
K <- (D_i - d_i) / d_i^2K
[1] 29.569
Interpretação:\(K_i\) ≤ 0,15 aleatório; entre 0,15 e 1 tendência ao agrupamento; > 1 agregado.
Índice de Payandeh (\(P_i\))
Relação entre a variância e a média do número de árvores por parcela:
\[P_i = \frac{S_i^2}{M_i}\]
P <- S2 / M_iP
[1] 13.22242
Interpretação:\(P_i\) ≤ 1 aleatório; entre 1 e 1,5 tendência ao agrupamento; > 1,5 agregado.
Índice não aleatorizado (\(R_i\)) e índice de Hazen (\(IH_i\))
O índice não aleatorizado é igual ao de Payandeh (\(R_i = S_i^2 / M_i\)), mas a decisão é feita por um teste de qui-quadrado. A estatística do teste é o próprio índice de Hazen:
\[\chi^2_i = IH_i = \frac{S_i^2}{M_i}(U_T - 1)\]
IH <- P * (UT -1)IH
[1] 185.1139
Em vez de procurar o valor na tabela impressa, usamos a função qchisq(), com \(U_T - 1\) graus de liberdade:
As tabelas de qui-quadrado e F usadas em aula estão neste PDF (Santana & Ranal, Análise da germinação: um enfoque estatístico; reproduzidas de Rohlf & Sokal 1995). Na tabela de qui-quadrado, procure a linha \(\nu = U_T - 1 = 14\) e a coluna do nível de significância \(\alpha\) (lembre que 95% de probabilidade corresponde a \(\alpha = 0{,}05\)):
Valor crítico
Coluna da tabela
Tabela impressa
R
\(\chi^2\) a 95%
\(\alpha = 0{,}05\)
23,685
qchisq(0.95, 14) = 23,685
\(\chi^2\) a 99%
\(\alpha = 0{,}01\)
29,141
qchisq(0.99, 14) = 29,141
\(\chi^2\) a 75%
\(\alpha = 0{,}25\)
não consta
qchisq(0.75, 14) = 17,117
\(F\) a 95% (14 e ∞ gl)
\(\nu_1 = 14\), \(\nu_2 = 240\) (última linha)
≈ 1,73
qf(0.95, 14, Inf) = 1,692
Repare que a tabela não traz a coluna de 75% (usada no índice de Hazen) nem a linha de infinitos graus de liberdade (usada no teste de Morisita). Nesses casos, o R resolve: qchisq() e qf() dão o valor exato para quaisquer graus de liberdade.
Interpretação:
Não aleatorizado: se \(\chi^2_i\) > \(\chi^2_{95\%}\), o desvio da aleatoriedade é significativo e a espécie é agregada; caso contrário, aleatória.
Hazen: se \(IH_i\) < \(\chi^2_{75\%}\), não agrupada; se \(IH_i\) > \(\chi^2_{99\%}\), agrupada; entre os dois, tendência ao agrupamento.
IH >qchisq(0.95, gl) # não aleatorizado: agregada?
                 indice  valor
1            MacGuinnes  12.99
2    Fracker e Brischle  29.57
3              Payandeh  13.22
4 Não aleatorizado (χ²) 185.11
5                 Hazen 185.11
6              Morisita   3.19
Myrcia sulfiflora é agregada segundo todos os índices. Faz sentido? Volte à tabela da seção 1: em quantos caixetais ela aparece?
Sua vez!
Exercício
Repita todos os cálculos acima para Calophyllum brasiliensis. Basta trocar o nome da espécie na primeira linha (n_ij <- tab["Calophyllum brasiliensis", ]) e rodar os blocos de novo. Classifique o padrão segundo cada índice antes de abrir a resposta.
Resposta
n_ij <- tab["Calophyllum brasiliensis", ]n_i <-sum(n_ij); U_i <-sum(n_ij >0); M_i <-mean(n_ij); S2 <-var(n_ij)D_i <- n_i / UT; d_i <--log(1- U_i / UT)IGA <- D_i / d_iK <- (D_i - d_i) / d_i^2P <- S2 / M_iIH <- P * (UT -1)IM <- UT *sum(n_ij * (n_ij -1)) / (n_i * (n_i -1))F_i <- (IM * (n_i -1) + UT - n_i) / (UT -1)round(c(n_i = n_i, U_i = U_i, IGA = IGA, K = K, P = P, IH = IH, IM = IM, F = F_i), 2)
  n_i   U_i   IGA     K     P    IH    IM     F
11.00  7.00  1.17  0.27  1.26 17.64  1.36  1.26
Compare com os valores críticos: \(\chi^2_{75\%}\) = 17.12, \(\chi^2_{95\%}\) = 23.68, \(\chi^2_{99\%}\) = 29.14 e \(F\) = 1.69. Aqui os índices não concordam totalmente: MacGuinnes, Fracker e Brischle, Payandeh e Hazen indicam tendência ao agrupamento, enquanto o teste do índice não aleatorizado e o de Morisita não detectam desvio significativo da aleatoriedade.
3. Resumo das fórmulas
Para cada espécie i, com \(n_{ij}\) = número de árvores na parcela j, \(n_i\) = total de árvores, \(U_i\) = parcelas em que ocorre e \(U_T\) = total de parcelas:
Índice
Fórmula
Interpretação
MacGuinnes
\(IGA_i = D_i / d_i\), com \(D_i = n_i/U_T\) e \(d_i = -\ln(1 - U_i/U_T)\)
em que \(M_i\) é a média e \(S_i^2\) a variância (com \(U_T - 1\) no denominador) do número de árvores por parcela.
No índice de Fracker e Brischle usamos a diferença \(D_i - d_i\)com sinal, como nas tabelas de Souza e Soares (2014): valores negativos indicam padrão aleatório ou uniforme.
4. Uma função para calcular todas as espécies
Fazer espécie por espécie dá trabalho. A função abaixo reúne os mesmos cálculos da seção 2 e os aplica a todas as linhas da tabela de uma vez, já classificando o padrão. Copie a função inteira e rode.
indices_agregacao <-function(tab, UT =ncol(tab)) { n_i <-rowSums(tab) # total de árvores U_i <-rowSums(tab >0) # parcelas com a espécie M_i <- n_i / UT # média por parcela S2 <-apply(tab, 1, function(x) sum((x -mean(x))^2) / (UT -1)) # variância# MacGuinnes e Fracker & Brischle (indefinidos se a espécie ocorre em todas as parcelas) D_i <- n_i / UT d_i <-ifelse(U_i < UT, -log(1- U_i / UT), NA) IGA <- D_i / d_i K <- (D_i - d_i) / d_i^2# Payandeh / não aleatorizado / Hazen P <- S2 / M_i qui <- P * (UT -1) # = IH (índice de Hazen)# Morisita e teste F IM <- UT *rowSums(tab * (tab -1)) / (n_i * (n_i -1)) F_i <- (IM * (n_i -1) + UT - n_i) / (UT -1)# Valores críticos chi95 <-qchisq(0.95, UT -1) chi75 <-qchisq(0.75, UT -1) chi99 <-qchisq(0.99, UT -1) F95 <-qf(0.95, UT -1, Inf) classe <-function(x, cortes, rotulos) as.character(cut(x, cortes, rotulos, right =TRUE))data.frame( n_i, U_i, D_i =round(D_i, 2), d_i =round(d_i, 2),S2 =round(S2, 2), M_i =round(M_i, 2),IGA =round(IGA, 2), K =round(K, 2), P =round(P, 2),IH =round(qui, 2), IM =round(IM, 2), F =round(F_i, 2),IGA_cl =ifelse(is.na(IGA), "-", ifelse(abs(IGA -1) <1e-9, "Aleat.",classe(IGA, c(-Inf, 1, 2, Inf), c("Unif.", "T.Agr.", "Agreg.")))),K_cl =ifelse(is.na(K), "-", classe(K, c(-Inf, 0.15, 1, Inf), c("Aleat.", "T.Agr.", "Agreg."))),P_cl =classe(P, c(-Inf, 1, 1.5, Inf), c("Aleat.", "T.Agr.", "Agreg.")),R_cl =ifelse(qui > chi95, "Agreg.", "Aleat."),IH_cl =ifelse(qui < chi75, "Não agr.", ifelse(qui > chi99, "Agreg.", "T.Agr.")),IM_cl =ifelse(F_i > F95, "Agreg.", ifelse(IM <1, "Unif.", "Aleat.")),check.names =FALSE )}
5. Resultados
Espécies com pouquíssimos indivíduos não permitem avaliar o padrão espacial. Por isso, calculamos os índices só para as espécies com pelo menos 5 árvores:
res <-indices_agregacao(tab[rowSums(tab) >=5, ], UT = UT)knitr::kable(res[, 1:12], caption ="Estimativas dos índices por espécie (15 parcelas de 10 × 20 m).")
Estimativas dos índices por espécie (15 parcelas de 10 × 20 m).
Classificação do padrão espacial (Agreg. = agregado; T.Agr. = tendência ao agrupamento; Aleat. = aleatório; Unif. = uniforme).
MacGuinnes
Fracker-Brischle
Payandeh
Não aleat.
Hazen
Morisita
Tabebuia cassinoides
-
-
Agreg.
Agreg.
Agreg.
Agreg.
Myrcia sulfiflora
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Mela 1
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
jussara
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Calophyllum brasiliensis
T.Agr.
T.Agr.
T.Agr.
Aleat.
T.Agr.
Aleat.
Psidium sp
T.Agr.
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Alchornea triplinervia
Unif.
Aleat.
Aleat.
Aleat.
Não agr.
Unif.
Coussapoa micropoda
T.Agr.
Agreg.
Agreg.
Agreg.
T.Agr.
Agreg.
Ilex durosa
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Agreg.
Valores críticos usados nos testes (\(U_T - 1\) = 14 graus de liberdade): \(\chi^2_{0,95}\) = 23.685, \(\chi^2_{0,75}\) = 17.117, \(\chi^2_{0,99}\) = 29.141 e \(F_{0,95}\) = 1.692. No R, qchisq() e qf() substituem a consulta às tabelas impressas.
A escala importa: a caixeta dentro de cada local
Várias espécies ocorrem em apenas um dos três locais (veja a tabela do passo 1). Com as 15 parcelas juntas, parte da “agregação” reflete a diferença entre caixetais, e não o arranjo das árvores dentro de cada um. Para a caixeta, que ocorre nos três locais, podemos repetir a análise separadamente:
caixeta_local <-t(sapply(split(arv, arv$local), function(d) { parcelas <-unique(d$parc) # 5 parcelas do local n <-sapply(parcelas, function(p) sum(d$parc == p & d$especie =="Tabebuia cassinoides")) r <-indices_agregacao(matrix(n, nrow =1), UT =length(parcelas))unlist(r[, c("n_i", "M_i", "S2", "P", "IM", "P_cl", "R_cl", "IM_cl")])}))knitr::kable(caixeta_local, caption ="Índices para *Tabebuia cassinoides* em cada caixetal (5 parcelas por local).")
Índices para Tabebuia cassinoides em cada caixetal (5 parcelas por local).
n_i
M_i
S2
P
IM
P_cl
R_cl
IM_cl
chauas
191
38.2
181.7
4.76
1.08
Agreg.
Agreg.
Agreg.
jureia
87
17.4
47.3
2.72
1.08
Agreg.
Agreg.
Agreg.
retiro
132
26.4
362.3
13.72
1.39
Agreg.
Agreg.
Agreg.
Para pensar
Os índices nem sempre concordam, principalmente na faixa de “tendência ao agrupamento”. O índice de Payandeh tende a classificar mais espécies como agregadas que o de MacGuinnes. Por isso é comum apresentar mais de um índice e discutir as diferenças.
Os índices de MacGuinnes e Fracker e Brischle ficam indefinidos quando a espécie ocorre em todas as parcelas (\(U_i = U_T\)), como na Tabela 1.4 do livro para Siparuna arianae.
O índice de Payandeh não tem uma classe “uniforme”: espécies regulares aparecem como aleatórias (\(P_i \leq 1\)).
Compare a caixeta nas 15 parcelas e dentro de cada local. O que muda? O que isso diz sobre o tamanho e a distribuição das unidades amostrais?
6. Exercícios
Para entregar (EE3)
Quantos fustes e quantas árvores há nos dados? Por que os índices devem ser calculados com árvores e não com fustes?
Monte uma tabela com os índices de agregação das espécies com pelo menos 5 árvores e classifique o padrão de cada uma segundo os seis índices.
Para quais espécies os índices discordam? Qual índice você considera mais adequado para esses dados e por quê?
Tabebuia cassinoides ocorre em todas as 15 parcelas. Por que os índices de MacGuinnes e Fracker e Brischle não podem ser calculados para ela?
Compare o padrão da caixeta considerando as 15 parcelas juntas e cada caixetal separadamente. O que isso revela sobre o tamanho e a distribuição das unidades amostrais na avaliação do padrão espacial?
Proponha uma explicação ecológica (dispersão, regeneração, ambiente) para o padrão encontrado para a caixeta. Use a literatura.
Para o relatório (formato de artigo)
Esta prática gera a Tabela 1 (índices de agregação das espécies com pelo menos 5 árvores) e a comparação da caixeta entre as escalas (15 parcelas × cada caixetal). As respostas dos exercícios 5 e 6 viram parágrafos de resultados e discussão.
7. Para saber mais: conferindo com o livro
Os índices de MacGuinnes, Fracker e Brischle e Payandeh podem ser calculados só a partir de \(n_i\), \(U_i\) e \(S_i^2\). Vamos conferir com três espécies da Tabela 1.4 de Souza e Soares (2014), inventário da Mata da Silvicultura em Viçosa (MG), com \(U_T = 10\) parcelas:
                  especie  IGA     K    P
1 Anadenanthera peregrina 4.72  2.31 7.05
2      Cecropia hololeuca 0.98 -0.02 0.86
3         Ocotea pretiosa 1.78  0.34 2.57
Os valores batem com os do livro: A. peregrina (IGA = 4,72; K = 2,31; P = 7,05), C. hololeuca (0,98; −0,02; 0,85) e O. pretiosa (1,78; 0,34; 2,57). Diferenças na segunda casa decimal vêm do arredondamento de \(S_i^2\) na tabela do livro.
8. Distribuições de probabilidade
Outra forma de avaliar o padrão é verificar qual distribuição de probabilidade descreve melhor o número de indivíduos por parcela: Poisson (padrão aleatório) ou binomial negativa (padrão agregado).
Usamos o exemplo de Souza e Soares (2014): uma área de 9 ha dividida em 100 parcelas de 30 × 30 m, com 44 indivíduos da espécie A.
n_ind <-0:4# nº de indivíduos por parcelan_parcelas <-c(73, 18, 3, 4, 2) # nº de parcelas (Tabela 1.5)N <-sum(n_parcelas) # 100 parcelasmu <-sum(n_ind * n_parcelas) / N # média = 0,44 indivíduo/parcelamu
[1] 0.44
Poisson
\[P(x) = e^{-\mu}\frac{\mu^x}{x!}\]
p_pois <-dpois(n_ind, lambda = mu)p_pois <-c(p_pois, 1-sum(p_pois)) # inclui a classe "> 4"esp_pois <- N * p_poisdata.frame(x =c(n_ind, ">4"), P =round(p_pois, 4), Esperado =round(esp_pois, 2))
A binomial negativa tem dois parâmetros: a média \(\mu\) e o expoente \(k\), estimado inicialmente por \(\hat{k} = \bar{X}^2 / (S^2 - \bar{X})\):
S2 <- (sum(n_ind^2* n_parcelas) -sum(n_ind * n_parcelas)^2/ N) / N # como no livro (denominador n)k <- mu^2/ (S2 - mu)c(S2 = S2, k = k)
       S2         k
0.7864000 0.5588915
p_bn <-dnbinom(n_ind, size = k, mu = mu) # mesmo que as fórmulas P(0), P(1)... do livrop_bn <-c(p_bn, 1-sum(p_bn))esp_bn <- N * p_bndata.frame(x =c(n_ind, ">4"), P =round(p_bn, 4), Esperado =round(esp_bn, 2))
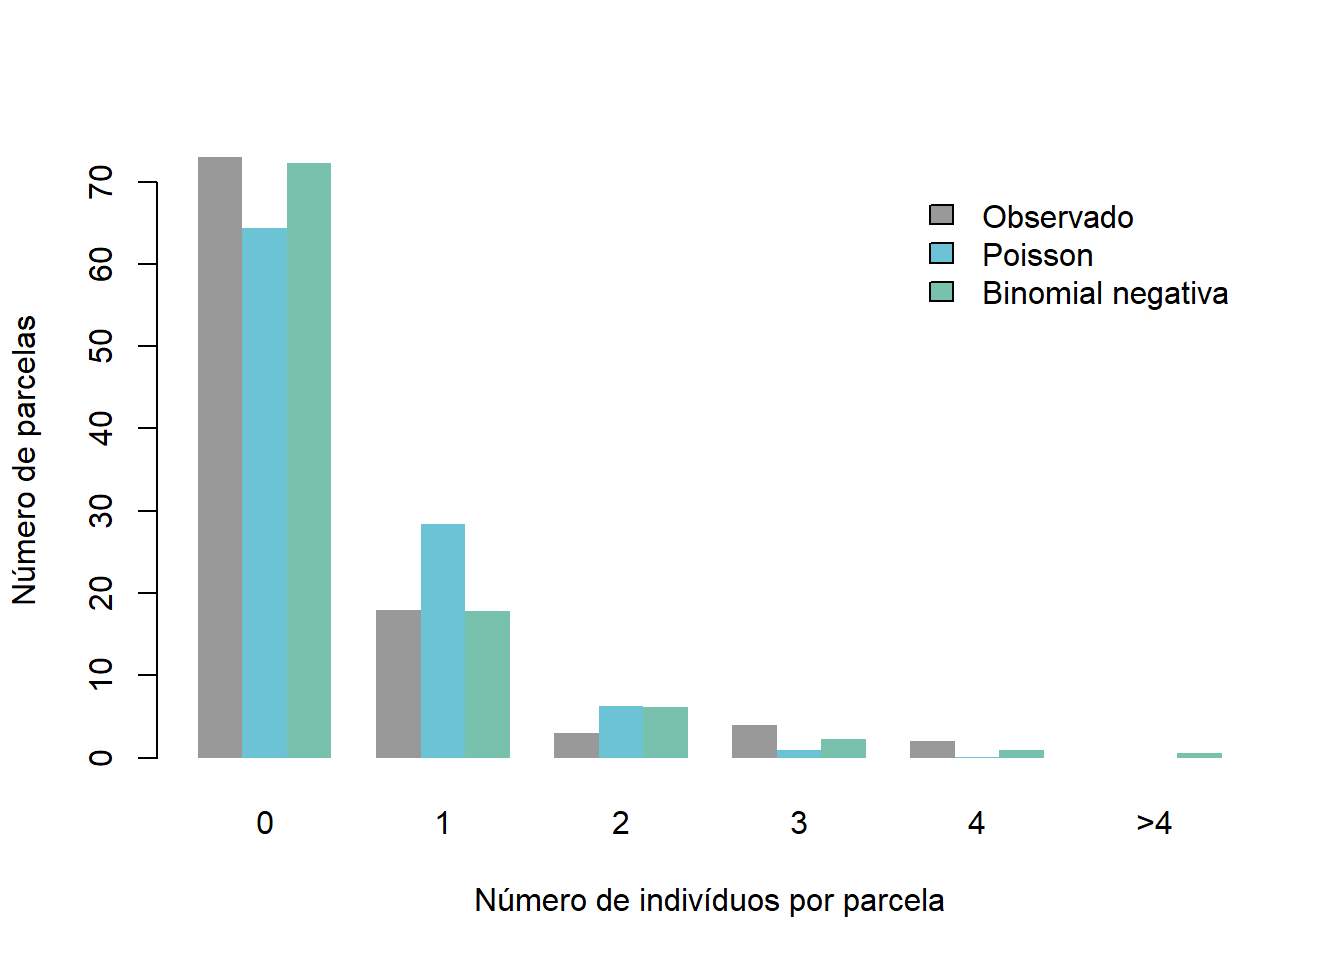
A Poisson é rejeitada e a binomial negativa se ajusta aos dados: a espécie A tem padrão agregado. Os valores de \(\chi^2\) diferem um pouco dos do livro (53,20 e 4,79) porque o R não arredonda as probabilidades intermediárias.
O qui-quadrado fica instável quando as frequências esperadas são muito pequenas (< 5). Em trabalhos, é recomendável juntar as últimas classes (por exemplo, “3 ou mais”) antes do teste (Krebs 1999).
m <-rbind(Observado = obs, Poisson = esp_pois, `Binomial negativa`= esp_bn)colnames(m) <-c(n_ind, ">4")barplot(m, beside =TRUE, col =c("grey60", "#6cc3d5", "#78c2ad"), border =NA,xlab ="Número de indivíduos por parcela", ylab ="Número de parcelas",legend.text =TRUE, args.legend =list(bty ="n"))
Número de parcelas observado e esperado pelos modelos de Poisson e binomial negativa.
9. E se eu tiver as coordenadas das árvores? A função K de Ripley
Os dados caixeta não têm a posição das árvores: só sabemos em que parcela cada uma está. Quando temos as coordenadas (x, y) de cada árvore, podemos usar a função K de Ripley, que avalia o padrão espacial em várias distâncias ao mesmo tempo, sem depender do tamanho das parcelas.
Esta seção usa o pacote spatstat. Instale uma vez com install.packages("spatstat").
Os dados: Beilschmiedia pendula em Barro Colorado
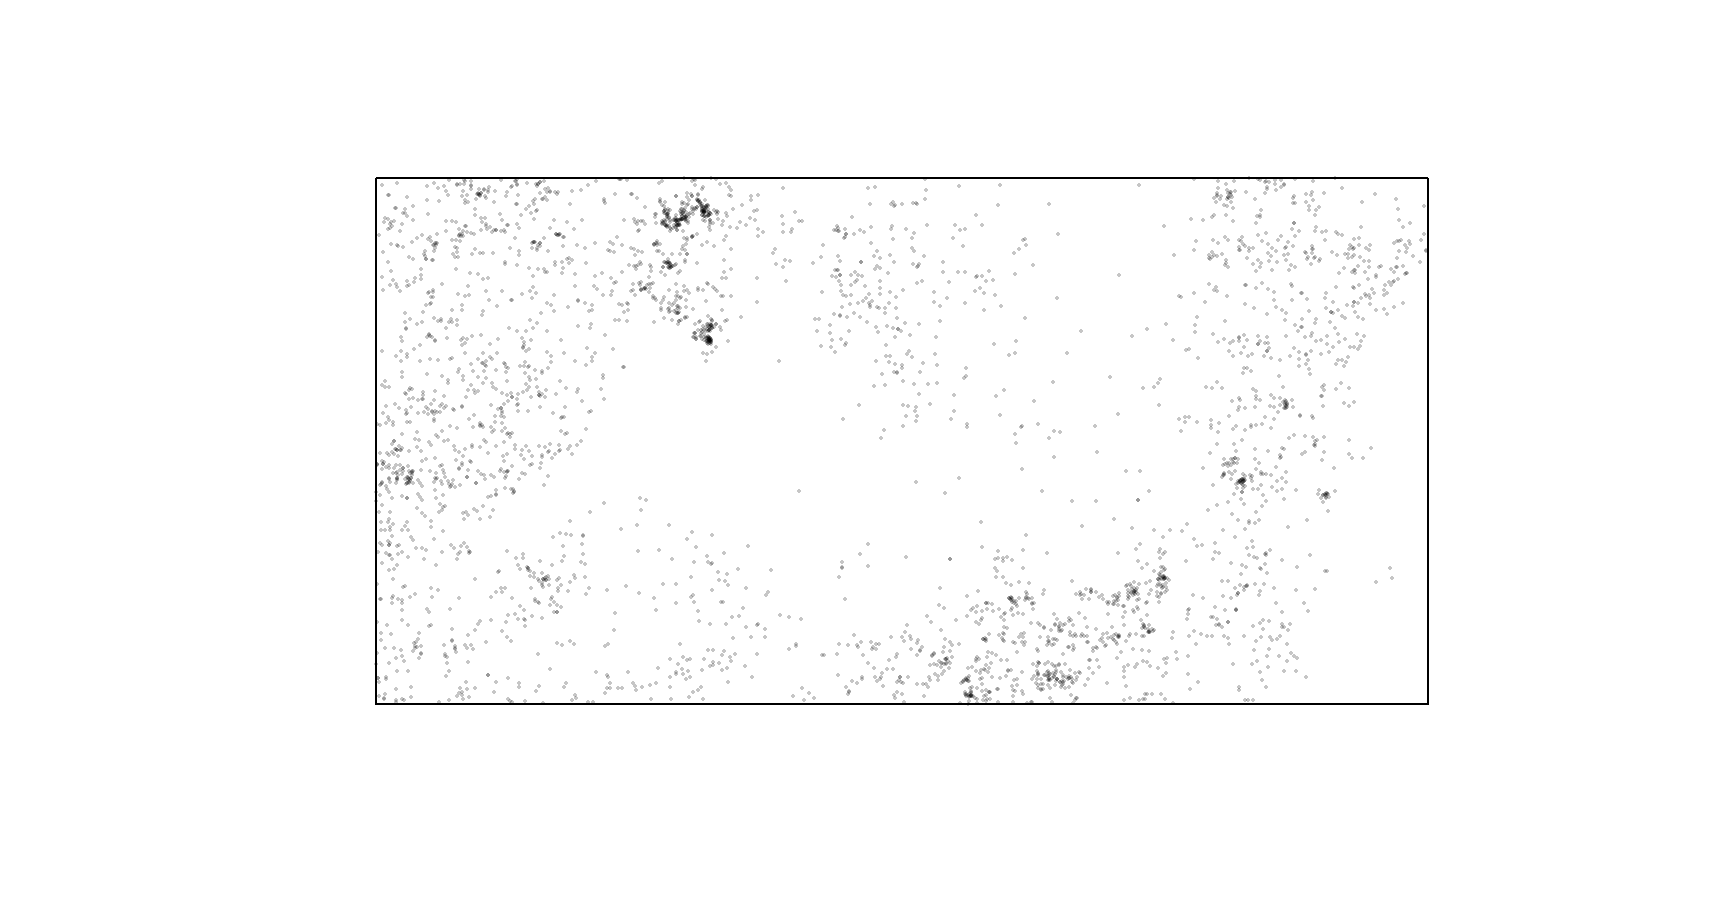
O spatstat traz um conjunto de dados reais muito usado em ecologia florestal: a localização de 3.604 árvores de Beilschmiedia pendula (Lauraceae) na parcela permanente de 50 ha (1.000 × 500 m) da Ilha de Barro Colorado, no Panamá (Hubbell & Foster 1983; Condit 1998).
library(spatstat)data(bei)bei # um "padrão de pontos" (ppp): coordenadas + janela da parcela
Planar point pattern: 3604 points
window: rectangle = [0, 1000] x [0, 500] metres
plot(bei, pch =16, cex =0.3, main ="")
Posição das 3.604 árvores de Beilschmiedia pendula na parcela de 50 ha de Barro Colorado.
Olhando o mapa, o que você diria: aleatório, regular ou agregado?
Ponte com os índices: dividindo a parcela em subparcelas
Para usar os índices das seções anteriores, dividimos a parcela em subparcelas e contamos as árvores em cada uma, como num inventário. Com 20 × 10 subparcelas, cada uma tem 50 × 50 m (0,25 ha):
q <-quadratcount(bei, nx =20, ny =10)n_ij <-as.vector(q) # nº de árvores em cada uma das 200 subparcelassummary(n_ij)
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   0.00    4.00   12.00   18.02   24.25  139.00
            n_i U_i   M_i     S2     P   IM   P_cl   R_cl  IM_cl
B. pendula 3604 178 18.02 436.94 24.25 2.28 Agreg. Agreg. Agreg.
E se mudarmos o tamanho das subparcelas?
tamanhos <-list("100 × 100 m (1 ha)"=c(10, 5),"50 × 50 m (0,25 ha)"=c(20, 10),"20 × 20 m (0,04 ha)"=c(50, 25),"10 × 10 m (0,01 ha)"=c(100, 50))escala <-t(sapply(tamanhos, function(g) { n <-as.vector(quadratcount(bei, nx = g[1], ny = g[2])) r <-indices_agregacao(matrix(n, nrow =1), UT =length(n))c(subparcelas =length(n), media =round(mean(n), 2), Payandeh = r$P, Morisita = r$IM)}))escala
                    subparcelas media Payandeh Morisita
100 × 100 m (1 ha)           50 72.08    52.83     1.70
50 × 50 m (0,25 ha)         200 18.02    24.25     2.28
20 × 20 m (0,04 ha)        1250  2.88     9.02     3.78
10 × 10 m (0,01 ha)        5000  0.72     4.19     5.42
Em todos os tamanhos a espécie é agregada, mas o valor dos índices muda bastante com o tamanho da subparcela. Esse é o problema que a função K resolve.
A função K de Ripley e a função L
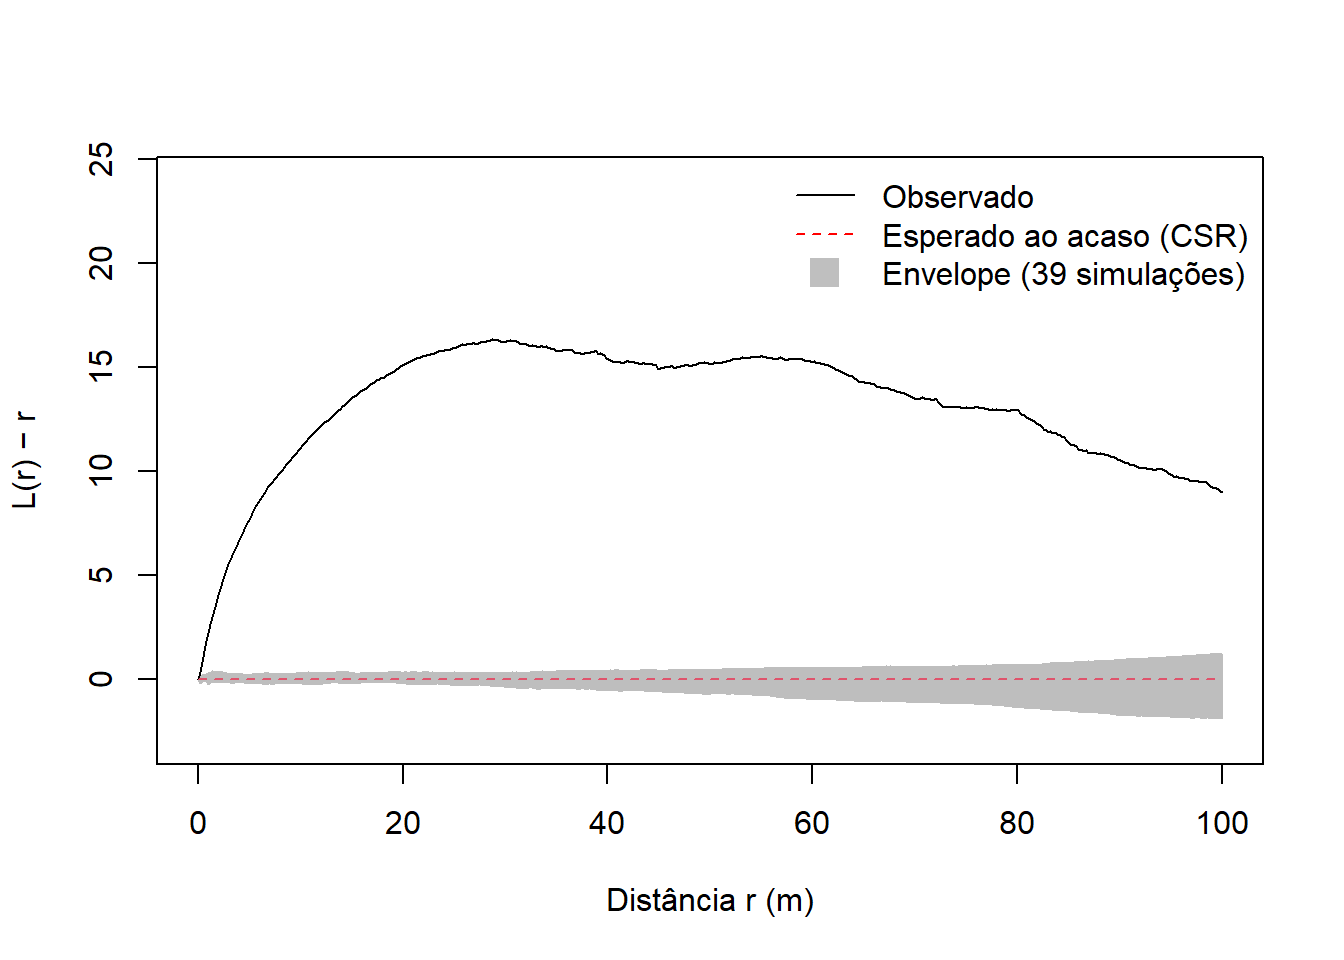
Para cada árvore, a função K(r) conta quantas outras árvores existem num círculo de raio r ao seu redor e compara com o esperado num padrão aleatório (completamente aleatório, CSR). Na prática usamos a transformação L(r), em que o padrão aleatório vira uma reta: \(L(r) - r = 0\).
\(L(r) - r > 0\): há mais vizinhos do que o esperado ao acaso → agregação na distância r;
\(L(r) - r < 0\): há menos vizinhos do que o esperado → regularidade (inibição) na distância r.
Para saber se o desvio é significativo, simulamos vários padrões aleatórios com o mesmo número de árvores na mesma área e construímos um envelope. Com 39 simulações, o envelope corresponde a um teste com cerca de 5% de significância:
Função L(r) − r para Beilschmiedia pendula. A linha preta é o padrão observado; a faixa cinza é o envelope de 39 simulações de padrão aleatório; a linha tracejada é o esperado ao acaso (zero).
Interpretação: a curva observada fica muito acima do envelope em todas as distâncias até 100 m: Beilschmiedia pendula é agregada em várias escalas, com o desvio máximo em torno de 20 a 30 m.
Para pensar
A agregação pode ter duas origens bem diferentes:
processos biológicos, como dispersão de sementes perto da planta-mãe ou regeneração em clareiras; ou
heterogeneidade do ambiente: a espécie só ocorre onde o habitat é favorável.
Em Barro Colorado, B. pendula é mais abundante em certas faixas de altitude e declividade. O spatstat traz esses mapas (bei.extra) e a função Linhom(), que avalia a agregação descontando a variação da densidade causada pelo ambiente:
dens <-density(bei, sigma =50) # intensidade local (árvores/m²)env_in <-envelope(bei, Linhom, nsim =39, rmax =100,simulate =expression(rpoispp(dens)), verbose =FALSE)plot(env_in, . - r ~ r, legend =FALSE)
Referências
CONDIT, R. Tropical Forest Census Plots. Berlin: Springer, 1998.
HUBBELL, S. P.; FOSTER, R. B. 1983. Diversity of canopy trees in a neotropical forest and implications for conservation. In: SUTTON, S. L. et al. (eds.) Tropical Rain Forest: Ecology and Management. Oxford: Blackwell, p. 25-41.
BADDELEY, A.; RUBAK, E.; TURNER, R. Spatial Point Patterns: Methodology and Applications with R. Boca Raton: CRC Press, 2015.
RIPLEY, B. D. 1977. Modelling spatial patterns. Journal of the Royal Statistical Society B 39: 172-212.
KREBS, C. J. Ecological Methodology. 2. ed. Menlo Park: Benjamin/Cummings, 1999.
MORISITA, M. Measuring of the dispersion of individuals and analysis of the distributional patterns. Memoirs of the Faculty of Science, Kyushu University, Series E (Biology), v. 2, p. 215-235, 1959.