Índices de heterogeneidade: Shannon, Simpson e Pielou
Fitossociologia
Diversidade
Riqueza, índices de Shannon e Simpson, equabilidade de Pielou, números de Hill e teste t de Hutcheson para comparar os caixetais, com os dados abertos caixeta.
Uma comunidade é mais heterogênea (ou diversa) quando tem mais espécies (riqueza) e quando os indivíduos estão distribuídos de forma mais equilibrada entre elas (equabilidade). Os índices de heterogeneidade combinam esses dois componentes num único número.
Os caixetais são um ótimo exemplo: uma espécie, a caixeta, domina a comunidade. Como isso aparece nos índices?
Roteiro da aula prática (23/10 · EE6)
Calcular à mão, no R, os índices para um caixetal (seção 2);
Comparar os três caixetais com uma função (seção 3) e testar a diferença entre os índices de Shannon (seção 4);
Ver os índices como números de Hill (seção 5) e o efeito da espécie dominante (seção 6);
Responder aos exercícios (seção 7).
1. Dados
cx <-read.csv("../dados/caixeta.csv") # no seu projeto: read.csv("dados/caixeta.csv")cx$especie[cx$especie =="Callophyllum brasiliensis"] <-"Calophyllum brasiliensis"arv <-unique(cx[, c("local", "parcela", "arvore", "especie")]) # uma linha por árvoreab <-unclass(table(arv$local, arv$especie)) # local × espécieab[, 1:5]
incerteza em prever a espécie do próximo indivíduo
Simpson (dominância)
\(D = \sum \frac{n_i(n_i-1)}{N(N-1)}\)
probabilidade de dois indivíduos sorteados serem da mesma espécie
Gini-Simpson
\(1 - D\)
probabilidade de serem de espécies diferentes
Simpson inverso
\(1/D\)
número “efetivo” de espécies dominantes
Pielou
\(J' = H' / \ln S\)
equabilidade, de 0 a 1
em que \(p_i = n_i / N\) é a proporção de indivíduos da espécie i.
n <- ab["jureia", ]n <- n[n >0] # só as espécies presentesN <-sum(n); S <-length(n)p <- n / NH <--sum(p *log(p))D <-sum(n * (n -1)) / (N * (N -1))J <- H /log(S)c(N = N, S = S, Shannon =round(H, 3), Simpson_D =round(D, 3),Gini_Simpson =round(1- D, 3), Simpson_inv =round(1/ D, 2), Pielou =round(J, 3))
           N            S      Shannon    Simpson_D Gini_Simpson  Simpson_inv
     178.000       22.000        1.873        0.285        0.715        3.510
      Pielou
       0.606
Qual logaritmo? Usamos o logaritmo natural (\(\ln\), log() no R), e o resultado é dado em nats. Alguns trabalhos usam \(\log_2\) (bits) ou \(\log_{10}\). Os valores mudam, então só compare índices calculados com a mesma base.
3. Os três caixetais
heterogeneidade <-function(n) { n <- n[n >0]; N <-sum(n); S <-length(n); p <- n / N H <--sum(p *log(p)); D <-sum(n * (n -1)) / (N * (N -1))c(N = N, S = S, Shannon = H, Simpson_D = D, Gini_Simpson =1- D,Simpson_inv =1/ D, Pielou = H /log(S))}het <-t(apply(ab, 1, heterogeneidade))het <-rbind(het, total =heterogeneidade(colSums(ab)))knitr::kable(het, digits =3, caption ="Índices de heterogeneidade por caixetal.")
Índices de heterogeneidade por caixetal.
N
S
Shannon
Simpson_D
Gini_Simpson
Simpson_inv
Pielou
chauas
290
13
0.957
0.507
0.493
1.972
0.373
jureia
178
22
1.873
0.285
0.715
3.505
0.606
retiro
204
13
1.148
0.471
0.529
2.123
0.448
total
672
42
1.667
0.394
0.606
2.537
0.446
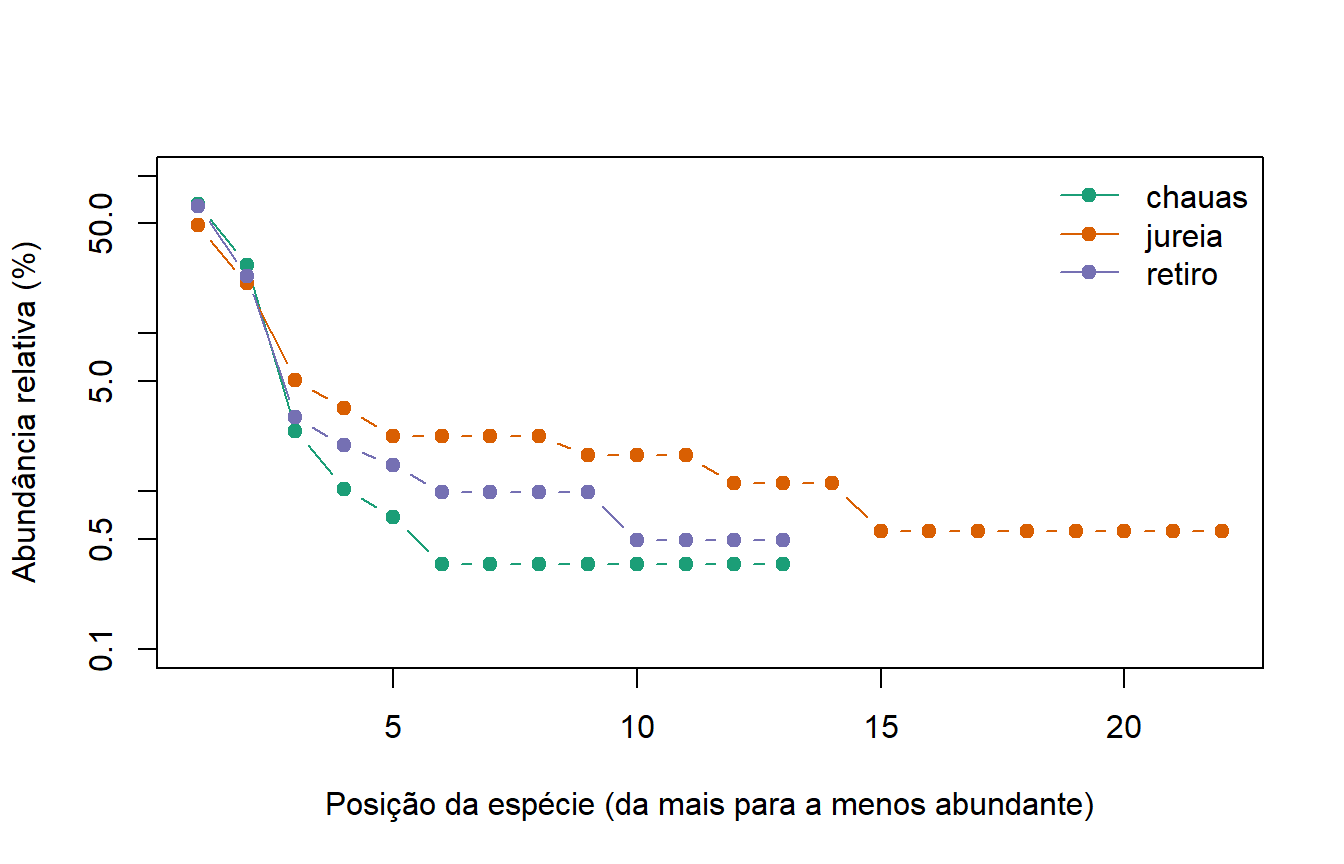
cores <-c(chauas ="#1b9e77", jureia ="#d95f02", retiro ="#7570b3")plot(NA, xlim =c(1, max(het[1:3, "S"])), ylim =c(0.1, 100), log ="y",xlab ="Posição da espécie (da mais para a menos abundante)",ylab ="Abundância relativa (%)")for (l inrownames(ab)) { pr <-sort(ab[l, ab[l, ] >0], decreasing =TRUE) /sum(ab[l, ]) *100lines(seq_along(pr), pr, type ="b", pch =19, col = cores[l])}legend("topright", legend =names(cores), col = cores, pch =19, lty =1, bty ="n")
Curvas de dominância-diversidade (abundância relativa em escala logarítmica por posição da espécie) nos três caixetais.
A curva de dominância-diversidade mostra os dois componentes ao mesmo tempo: o comprimento da curva é a riqueza, e a inclinação, a (falta de) equabilidade.
4. Os índices de Shannon diferem? Teste t de Hutcheson
Hutcheson (1970) propôs um teste t para comparar dois valores de \(H'\), usando a variância de cada um:
hutcheson <-function(n1, n2) { v <-function(n) { n <- n[n >0]; N <-sum(n); S <-length(n); p <- n / N H <--sum(p *log(p))c(H = H, var = (sum(p *log(p)^2) -sum(p *log(p))^2) / N + (S -1) / (2* N^2), N = N) } a <-v(n1); b <-v(n2) t <- (a["H"] - b["H"]) /sqrt(a["var"] + b["var"]) gl <- (a["var"] + b["var"])^2/ (a["var"]^2/ a["N"] + b["var"]^2/ b["N"])c(H1 = a[["H"]], H2 = b[["H"]], t = t[[1]], gl = gl[[1]], p =2*pt(-abs(t[[1]]), gl[[1]]))}pares <-combn(rownames(ab), 2)teste <-t(apply(pares, 2, function(x) hutcheson(ab[x[1], ], ab[x[2], ])))rownames(teste) <-apply(pares, 2, paste, collapse =" × ")knitr::kable(teste, digits =4, caption ="Teste t de Hutcheson entre os caixetais.")
Teste t de Hutcheson entre os caixetais.
H1
H2
t
gl
p
chauas × jureia
0.9572
1.8734
-7.0986
306.1799
0.0000
chauas × retiro
0.9572
1.1484
-1.7066
403.6121
0.0887
jureia × retiro
1.8734
1.1484
5.0858
355.8907
0.0000
5. Números de Hill: uma família de índices
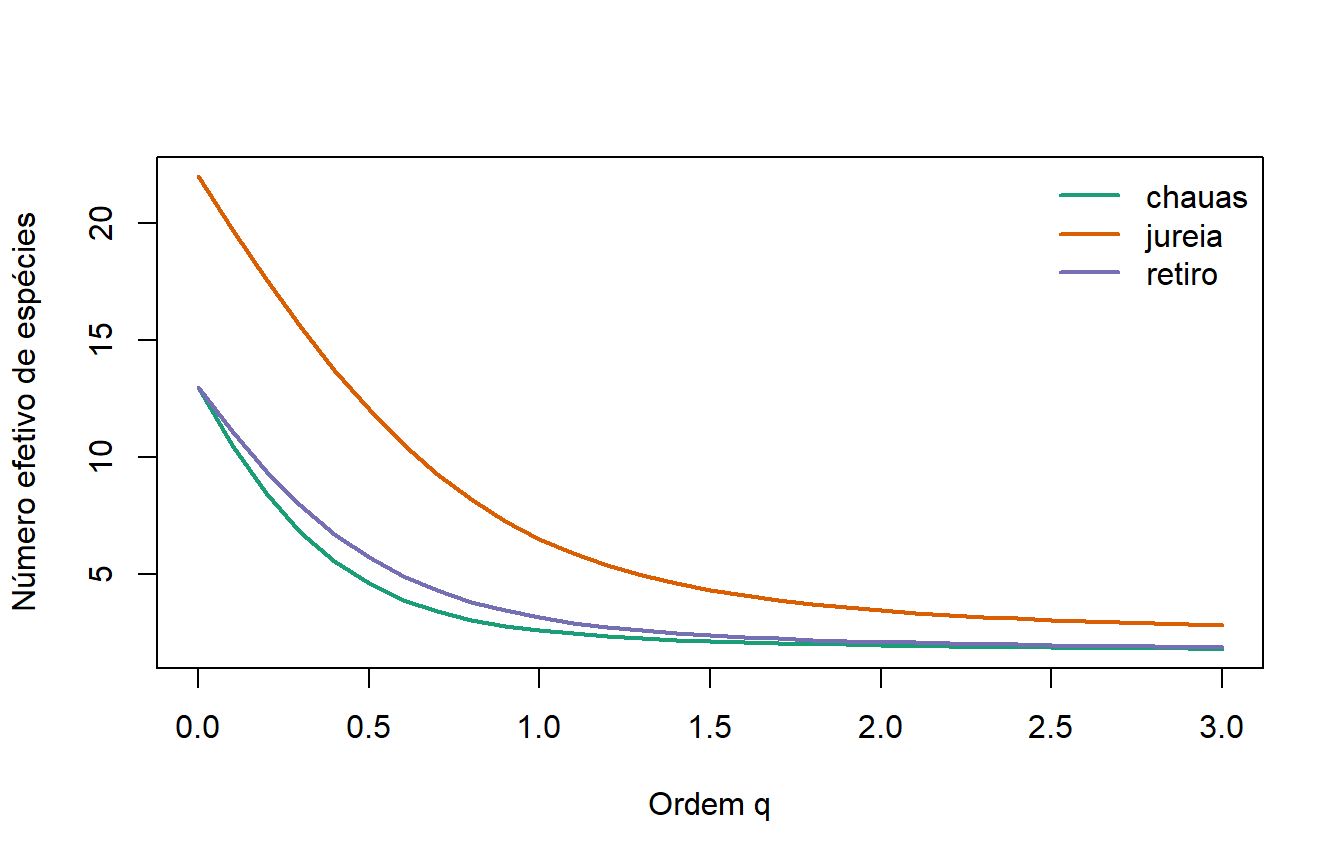
Riqueza, Shannon e Simpson podem ser vistos como membros de uma mesma família, os números de Hill (\(^qD\)), expressos em número efetivo de espécies:
\(^0D = S\) (riqueza: todas as espécies contam igualmente);
\(^1D = \exp(H')\) (espécies pesam pela abundância);
O que acontece com os índices se retirarmos a caixeta?
sem_caixeta <- ab[, colnames(ab) !="Tabebuia cassinoides"]knitr::kable(cbind(com = het[1:3, c("Shannon", "Pielou")],sem =t(apply(sem_caixeta, 1, heterogeneidade))[, c("Shannon", "Pielou")]),digits =3, col.names =c("H' (com)", "J' (com)", "H' (sem)", "J' (sem)"),caption ="Shannon e Pielou com e sem a caixeta.")
Shannon e Pielou com e sem a caixeta.
H’ (com)
J’ (com)
H’ (sem)
J’ (sem)
chauas
0.957
0.373
0.924
0.372
jureia
1.873
0.606
2.309
0.758
retiro
1.148
0.448
1.414
0.569
7. Exercícios
Para entregar (EE6)
Calcule à mão (calculadora ou Excel) \(H'\), \(D\) e \(J'\) para o caixetal de chauas e confira com a tabela da seção 3.
Qual caixetal é mais diverso? A resposta é a mesma para todos os índices?
As diferenças entre os valores de \(H'\) são significativas pelo teste de Hutcheson?
Explique, com o perfil de Hill, por que a diferença entre os caixetais diminui quando \(q\) aumenta.
O que acontece com \(H'\) e \(J'\) quando a caixeta é retirada? O que isso diz sobre a estrutura dos caixetais?
Compare os valores de \(H'\) dos caixetais com os de florestas de terra firme da Amazônia (procure na literatura). Por que são tão diferentes?
Para o relatório (formato de artigo)
Esta prática gera a Tabela 4 (índices de heterogeneidade por caixetal, com o teste de Hutcheson) e a Figura 4 (curvas de dominância-diversidade ou perfis de Hill).
Referências
HILL, M. O. Diversity and evenness: a unifying notation and its consequences. Ecology, v. 54, p. 427-432, 1973.
HUTCHESON, K. A test for comparing diversities based on the Shannon formula. Journal of Theoretical Biology, v. 29, p. 151-154, 1970.
MAGURRAN, A. E. Medindo a diversidade biológica. Curitiba: Ed. UFPR, 2011.
PIELOU, E. C. The measurement of diversity in different types of biological collections. Journal of Theoretical Biology, v. 13, p. 131-144, 1966.