Espectros NIR: do arquivo bruto à discriminação de espécies
Espectroscopia NIR
Taxonomia
Fluxo do curso Herbarium Spectroscopy with MicroNIR: gerar a matriz no ISC Reader App, ajustar e recortar os comprimentos de onda, remover leituras problemáticas, calcular médias por exsicata e discriminar espécies de Handroanthus com LDA e validação leave-one-out.
Esta rotina reproduz o fluxo de trabalho do curso Herbarium Spectroscopy with MicroNIR: theory and practice, realizado em abril de 2025 no Herbário do INPA pelo projeto SPECTRA POP. A rotina usa os dados reais do curso: espectros NIR de exsicatas de ipês (Handroanthus, Bignoniaceae), gênero com espécies listadas na CITES.
O fluxo tem duas partes, como no curso:
Preparação dos dados: arquivos brutos → matriz espectral → ajuste dos comprimentos de onda → recorte → controle de qualidade → médias por exsicata;
Análise discriminante: LDA com validação cruzada leave-one-out (LOO), matriz de confusão e acurácia com intervalo de confiança.
Dados e scripts originais
Vasconcelos, C. & Durgante, F. (2025). R codes and datasets used in the course “Herbarium Spectroscopy with MicroNIR: theory and practice” (v1.0.0). Zenodo. https://doi.org/10.5281/zenodo.15531968 (licença CC BY-SA 4.0)
Os scripts originais do curso (com ggplot2, dplyr e caret) estão no GitHub. Aqui o mesmo fluxo foi reescrito em R básico, passo a passo, e os resultados são idênticos.
Os dados
59 exsicatas do Herbário INPA de cinco espécies: Handroanthus barbatus, H. impetiginosus, H. incanus, H. ochraceus e H. serratifolius;
espectrômetro portátil NIR-S-G1 (InnoSpectra), faixa de 900 a 1700 nm, medindo reflectância;
cerca de 4 leituras por face da folha, abaxial (ab) e adaxial (ad), num total de 474 arquivos_r.csv.
Parte 1. Preparação dos dados
1. Gerar a matriz espectral no ISC Reader App
Cada leitura do NIR-S-G1 gera um arquivo .csv com um cabeçalho de configuração (modelo, número de série, data, temperatura etc.) e uma tabela de comprimento de onda × reflectância. O ISC Reader App junta todos esses arquivos numa única tabela.
Baixe o arquivo spectrapop-course-workflow.zip no Zenodo e descompacte. Os arquivos brutos estão em Datasets/Readings_from_micronir/.
Abra o ISC Reader App e marque Tipo de dado: Reflectância.
Em Selecione os arquivos brutos (.csv), clique em Browse… e selecione todos os arquivos _r.csv (Ctrl + A). Aguarde até aparecer Upload complete.
Confira os espectros nas abas Tabela, Espectros e PCA.
Clique em Download CSV e salve o arquivo na pasta dados/ do seu projeto do RStudio, com o nome matriz_isc_handroanthus.csv.
Se preferir pular esta etapa, baixe a matriz já pronta no topo desta página. Ela é exatamente a saída do app para os 474 arquivos.
2. Importar a matriz no R
A matriz tem uma linha por leitura (coluna File) e uma coluna por comprimento de onda:
m <-read.csv("../dados/matriz_isc_handroanthus.csv", check.names =FALSE) # no seu projeto: "dados/..."meta <-read.csv("../dados/handroanthus_metadados.csv")dim(m)
[1] 474 913
m[1:3, 1:6]
                                              File 900.860912737931
1 INPA0145168_ab_FolHerbario_20250403_110028_r.csv               NA
2 INPA0145168_ab_FolHerbario_20250403_110107_r.csv               NA
3 INPA0145168_ab_FolHerbario_20250403_110128_r.csv               NA
  900.868887283122 901.114121469303 901.701099874012 904.747472781646
1               NA               NA        0.2830460               NA
2               NA               NA        0.2900928               NA
3               NA               NA        0.2798360               NA
Informações no nome do arquivo
O nome de cada arquivo segue o padrão TOMBO_FACE_CONFIGURAÇÃO_DATA_HORA_r.csv, por exemplo INPA0145168_ab_FolHerbario_20250403_110028_r.csv. Separamos essas partes:
partes <-do.call(rbind, strsplit(sub("_r\\.csv$", "", m$File), "_"))info <-data.frame(barcode = partes[, 1], # código de barras da exsicataface = partes[, 2], # ab = abaxial; ad = adaxialconfig = partes[, 3],data = partes[, 4],hora = partes[, 5])info$leitura <-paste(info$barcode, info$face, info$hora, sep ="_")head(info, 3)
      barcode face      config     data   hora               leitura
1 INPA0145168   ab FolHerbario 20250403 110028 INPA0145168_ab_110028
2 INPA0145168   ab FolHerbario 20250403 110107 INPA0145168_ab_110107
3 INPA0145168   ab FolHerbario 20250403 110128 INPA0145168_ab_110128
Quantas leituras temos por exsicata e por face?
table(info$face)
 ab  ad
223 251
head(table(info$barcode, info$face))
              ab ad
  INPA0145168  8  0
  INPA0205825  4  4
  INPA0205827  4  4
  INPA0205828  0  8
  INPA0205832  4  4
  INPA0205833  4  4
3. Ajustar os comprimentos de onda
Repare nas células vazias (NA) da matriz. Cada aparelho tem uma calibração própria e mede em comprimentos de onda ligeiramente diferentes (por exemplo, 901,70 nm em um e 900,86 nm em outro). Como as leituras do curso foram feitas com mais de um NIR-S-G1, o app junta todos os comprimentos de onda, e cada leitura só tem valores nas colunas do seu aparelho.
Mas todas as leituras têm o mesmo número de pontos:
Como no curso, atribuímos a todas as leituras a mesma grade de referência: 228 pontos de 900 a 1700 nm, a cada 3,52 nm. Para cada leitura, pegamos os 228 valores na ordem e os colocamos nessa grade:
wl_ref <-seq(900, 1700, by =3.52)length(wl_ref)
[1] 228
X <-t(apply(R_bruto, 1, function(r) r[!is.na(r)])) # 228 valores de cada leitura, em ordemcolnames(X) <- wl_refdim(X)
[1] 474 228
4. Associar as espécies
Os metadados das exsicatas vêm da base do Herbário INPA (BRAHMS). Ligamos as espécies às leituras pelo código de barras:
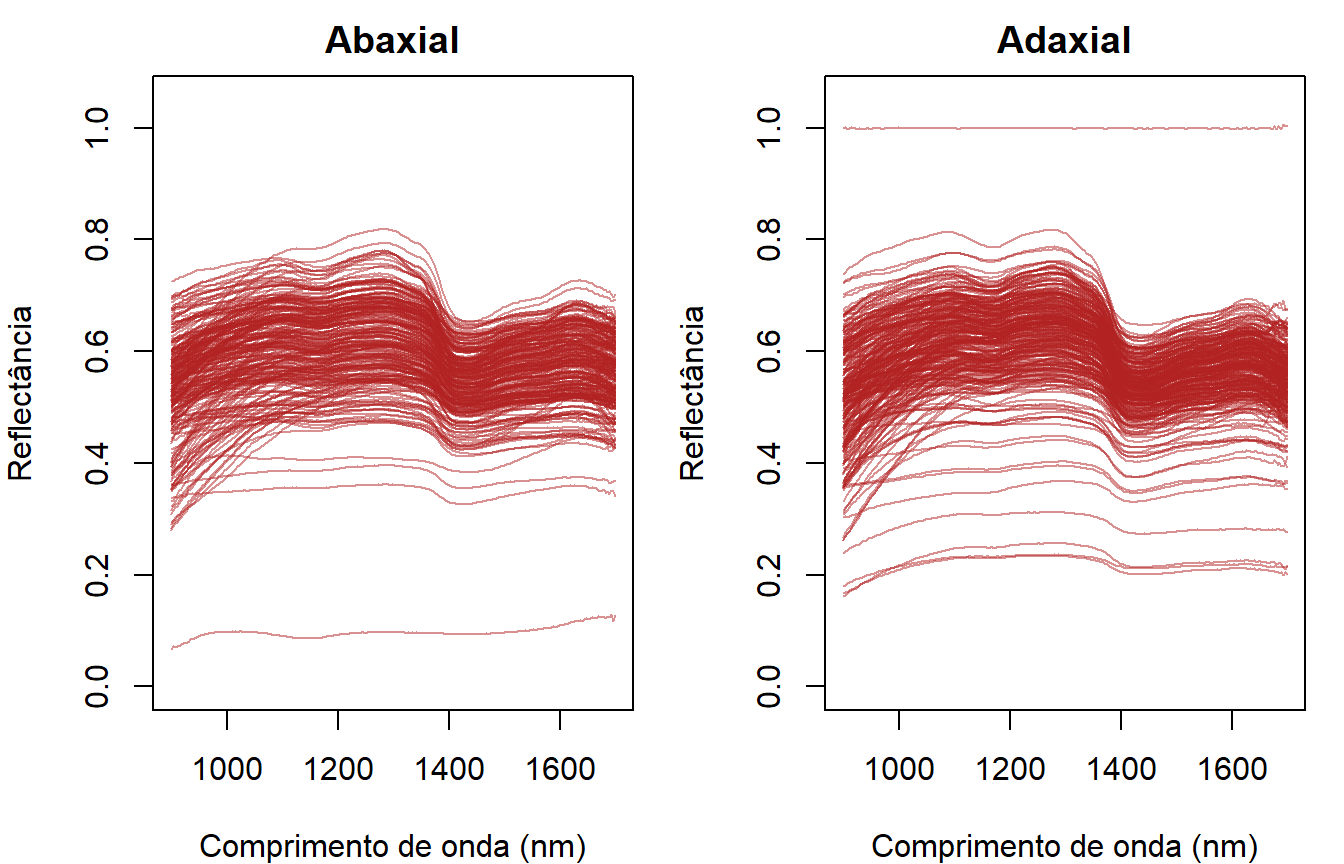
par(mfrow =c(1, 2), mar =c(4, 4, 2, 1))for (f inc("ab", "ad")) { sel <- info$face == fmatplot(wl_ref, t(X[sel, ]), type ="l", lty =1, col =adjustcolor("firebrick", 0.5),xlab ="Comprimento de onda (nm)", ylab ="Reflectância", ylim =c(0, 1.05),main =ifelse(f =="ab", "Abaxial", "Adaxial"))}
Espectros de reflectância brutos (474 leituras), por face da folha.
Recorte da faixa espectral
As extremidades da faixa do aparelho (abaixo de 950 nm e acima de 1650 nm) são mais ruidosas. Como no curso, ficamos com a faixa de 950 a 1650 nm:
manter <- wl_ref >=950& wl_ref <=1650X <- X[, manter]wl <- wl_ref[manter]ncol(X) # 199 comprimentos de onda
[1] 199
Controle de qualidade: leituras problemáticas
No curso, as leituras problemáticas foram identificadas olhando o gráfico interativo e passando o mouse sobre as curvas fora do padrão. Você pode fazer o mesmo no seu computador com o pacote plotly:
library(plotly)longo <-data.frame(leitura =rep(info$leitura, ncol(X)),wl =rep(wl, each =nrow(X)), refl =as.vector(X))plot_ly(longo, x =~wl, y =~refl, split =~leitura, type ="scatter", mode ="lines",line =list(width =1), showlegend =FALSE)
Seis leituras foram excluídas:
INPA0206014_ad_112909: reflectância “chapada” perto de 1,0 em toda a faixa (provavelmente a referência branca salva por engano);
INPA0206017_ab_102412: leitura muito escura (sensor mal posicionado sobre a folha);
quatro leituras adaxiais de INPA0206027, todas muito abaixo das demais.
remover <-c("INPA0206017_ab_102412", "INPA0206014_ad_112909","INPA0206027_ad_105717", "INPA0206027_ad_105558","INPA0206027_ad_105646", "INPA0206027_ad_105620")# como essas leituras se comparam às demais?round(rowMeans(X[info$leitura %in% remover, ]), 3)
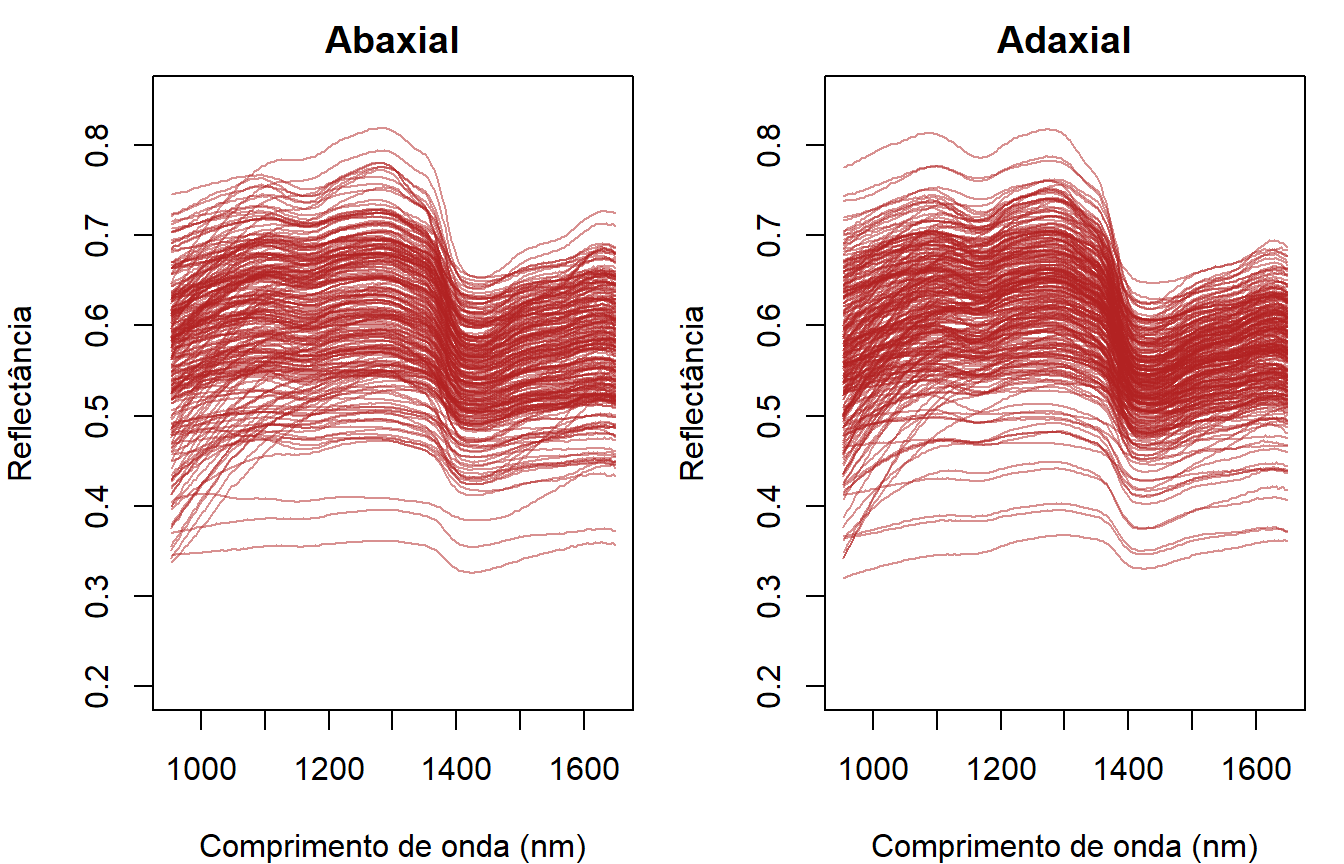
par(mfrow =c(1, 2), mar =c(4, 4, 2, 1))for (f inc("ab", "ad")) { sel <- info$face == fmatplot(wl, t(X[sel, ]), type ="l", lty =1, col =adjustcolor("firebrick", 0.5),xlab ="Comprimento de onda (nm)", ylab ="Reflectância", ylim =c(0.2, 0.85),main =ifelse(f =="ab", "Abaxial", "Adaxial"))}
Espectros de reflectância após o recorte (950–1650 nm) e a remoção das leituras problemáticas.
Os vales em torno de 1200 nm e 1450 nm correspondem à absorção pelas ligações O–H (água residual e celulose) e, perto de 1650 nm, pelas ligações C–H.
Sempre olhe os espectros antes de analisar. Registre quais leituras foram excluídas e por quê: isso faz parte da metodologia do seu trabalho.
6. Médias por exsicata: três conjuntos de dados
As várias leituras de uma mesma folha não são independentes: a unidade de análise é a exsicata. Calculamos o espectro médio de cada exsicata em três conjuntos de dados, como no curso:
abaxial + adaxial (todas as leituras);
só abaxial;
só adaxial.
media_exsicata <-function(sel) { g <-factor(info$barcode[sel]) M <-rowsum(X[sel, ], g) /as.vector(table(g))data.frame(especie = meta$especie[match(rownames(M), meta$barcode)],barcode =rownames(M), M, check.names =FALSE, row.names =NULL)}dados <-list("Abaxial + Adaxial"=media_exsicata(rep(TRUE, nrow(X))),"Abaxial"=media_exsicata(info$face =="ab"),"Adaxial"=media_exsicata(info$face =="ad"))sapply(dados, nrow) # nº de exsicatas em cada conjunto
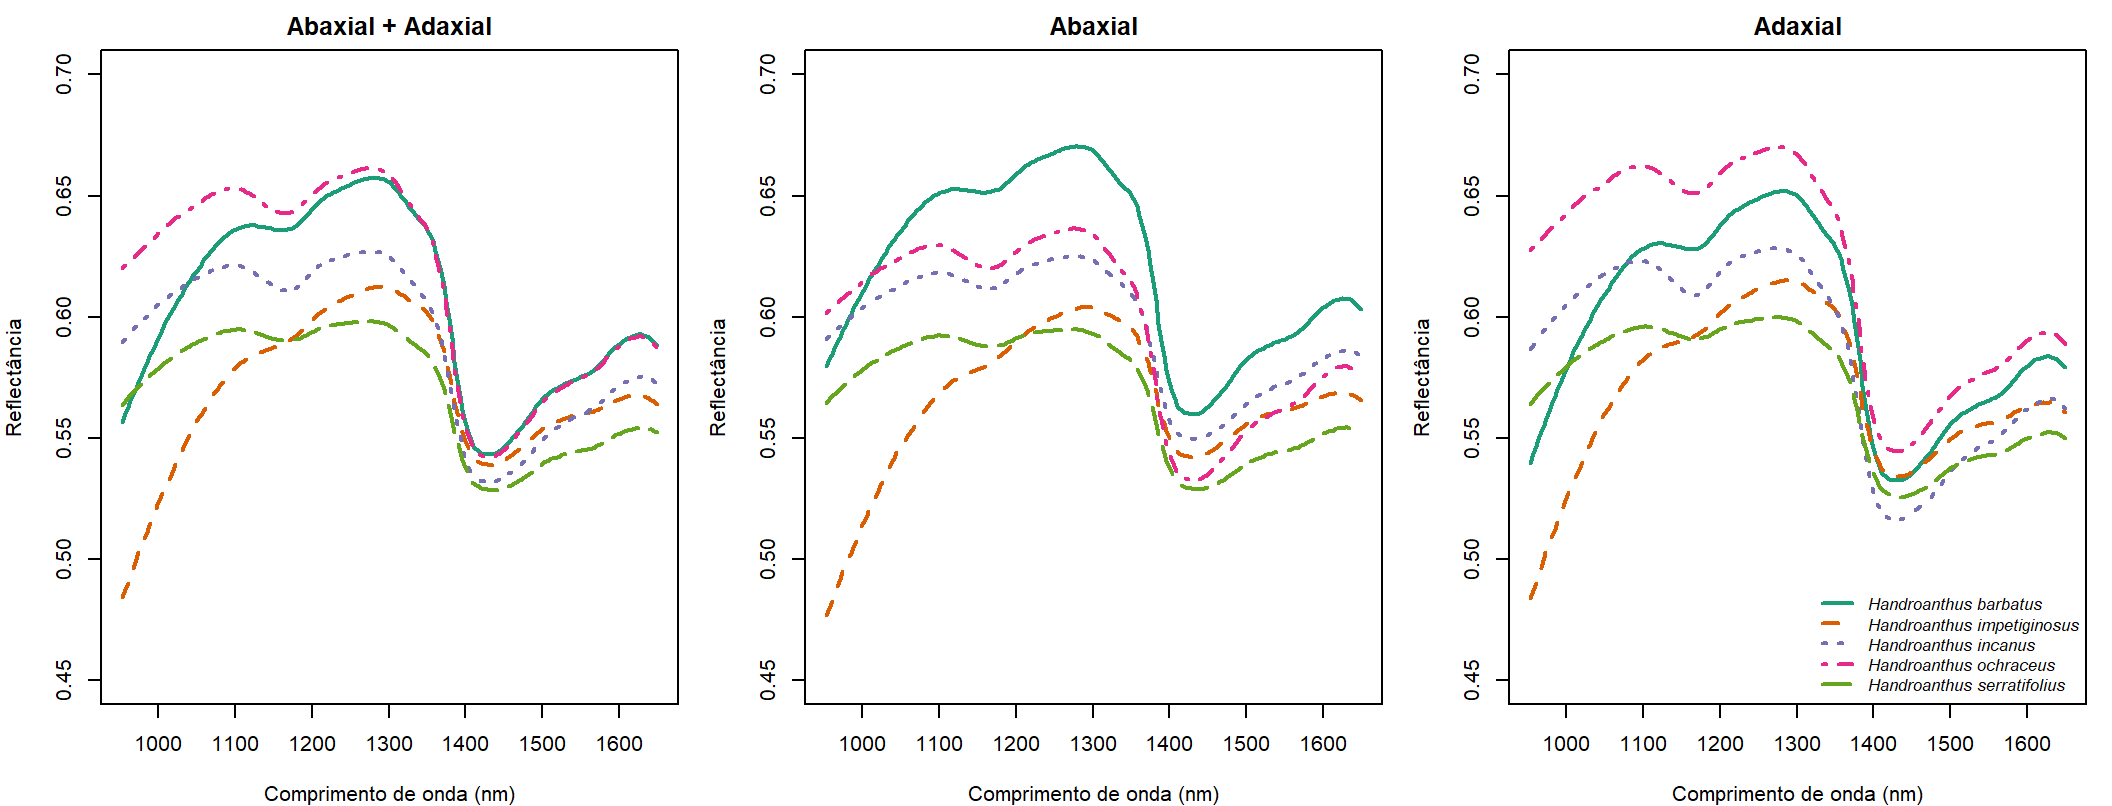
especies <-sort(unique(info$especie))cores <-setNames(c("#1b9e77", "#d95f02", "#7570b3", "#e7298a", "#66a61e"), especies)par(mfrow =c(1, 3), mar =c(4, 4, 2, 1))for (nm innames(dados)) { d <- dados[[nm]] medias <-rowsum(as.matrix(d[, -(1:2)]), d$especie) /as.vector(table(d$especie))matplot(wl, t(medias), type ="l", lty =1:5, lwd =2, col = cores[rownames(medias)],xlab ="Comprimento de onda (nm)", ylab ="Reflectância", main = nm, ylim =c(0.45, 0.7))}legend("bottomright", legend = especies, col = cores, lty =1:5, lwd =2, bty ="n",text.font =3, cex =0.8)
Reflectância média por espécie nos três conjuntos de dados.
Parte 2. Análise discriminante
7. LDA com validação leave-one-out
A análise discriminante linear (LDA) encontra as combinações de comprimentos de onda que melhor separam as espécies. Para saber se o modelo funciona com exsicatas novas, usamos a validação leave-one-out (LOO): retiramos uma exsicata, ajustamos o modelo com as demais, classificamos a exsicata retirada e repetimos para todas.
Além da espécie prevista, a LDA dá a probabilidade posterior de cada espécie. Como no curso, cada previsão é classificada em quatro tipos:
Tipo
Significado
Correta (significativa)
espécie certa, com probabilidade > 0,95
Correta (não significativa)
espécie certa, com probabilidade ≤ 0,95
Incorreta (significativa)
espécie errada, com probabilidade > 0,95
Incorreta (não significativa)
espécie errada, com probabilidade ≤ 0,95
library(MASS)lda_loo <-function(d) { Xd <-as.matrix(d[, -(1:2)]) # só as colunas espectrais y <-factor(d$especie) res <-data.frame(barcode = d$barcode, observada = y, prevista =NA, prob =NA) post <-matrix(NA, nrow(d), nlevels(y), dimnames =list(NULL, levels(y)))for (i inseq_len(nrow(d))) { modelo <-suppressWarnings(lda(Xd[-i, ], grouping = y[-i])) # ajusta sem a exsicata i previsao <-predict(modelo, Xd[i, , drop =FALSE]) # classifica a exsicata i res$prevista[i] <-as.character(previsao$class) res$prob[i] <-max(previsao$posterior) post[i, ] <- previsao$posterior } res$tipo <-paste0(ifelse(res$prevista == res$observada, "Correta", "Incorreta"),ifelse(res$prob >0.95, " (significativa)", " (não significativa)")) res$prevista <-factor(res$prevista, levels =levels(y))cbind(res, round(post, 4))}
O suppressWarnings() esconde o aviso de variáveis colineares: comprimentos de onda vizinhos são muito correlacionados. O curso usa a LDA diretamente sobre os 199 comprimentos de onda, sem pré-processamento.
Abaxial + adaxial
loo <-lda_loo(dados[["Abaxial + Adaxial"]])head(loo[, c("barcode", "observada", "prevista", "prob", "tipo")])
A acurácia é a proporção de exsicatas classificadas corretamente. O intervalo de confiança de 95% vem do teste binomial exato (o mesmo que a função confusionMatrix() do pacote caret, usada no curso, calcula):
                  Prevista
Observada          H. barbatus H. impetiginosus H. incanus H. ochraceus
  H. barbatus               14                0          0            0
  H. impetiginosus           0                8          0            0
  H. incanus                 0                1         14            0
  H. ochraceus               1                0          0            3
  H. serratifolius           0                0          0            0
                  Prevista
Observada          H. serratifolius
  H. barbatus                     1
  H. impetiginosus                1
  H. incanus                      0
  H. ochraceus                    3
  H. serratifolius               13
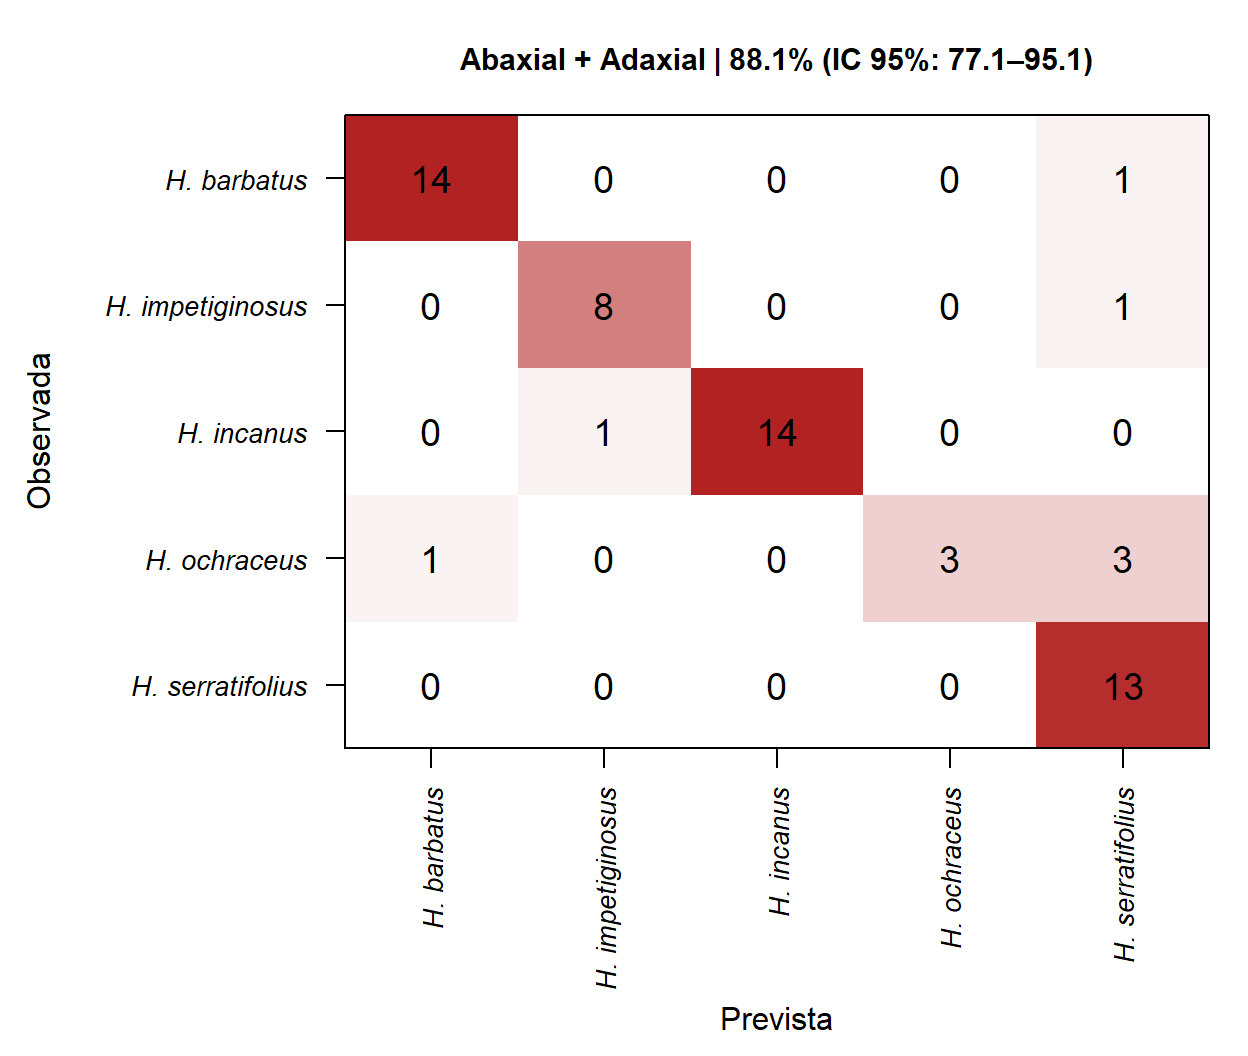
plot_confusao <-function(conf, titulo ="") { k <-nrow(conf)par(mar =c(8, 9, 3, 1))image(1:k, 1:k, t(conf[k:1, ]), col =colorRampPalette(c("white", "firebrick"))(20),axes =FALSE, xlab ="", ylab ="", main = titulo, cex.main =0.95)axis(1, 1:k, colnames(conf), las =2, font =3, cex.axis =0.85)axis(2, 1:k, rev(rownames(conf)), las =1, font =3, cex.axis =0.85)mtext("Prevista", side =1, line =6.5); mtext("Observada", side =2, line =7.5)for (i in1:k) for (j in1:k) text(j, k - i +1, conf[i, j], cex =1.2)box()}ac <-acuracia(loo)plot_confusao(conf, sprintf("Abaxial + Adaxial | %.1f%% (IC 95%%: %.1f–%.1f)", ac[1], ac[2], ac[3]))
Matriz de confusão (abaxial + adaxial). Na diagonal, as exsicatas classificadas corretamente.
Comparando as faces da folha
resultados <-lapply(dados, lda_loo)tabela <-t(sapply(resultados, function(r) { a <-acuracia(r)c(Exsicatas =nrow(r),`Acurácia (%)`=round(a[[1]], 1),`IC 95% (%)`=paste0(round(a[[2]], 1), "–", round(a[[3]], 1)),`Corretas p > 0,95`=sum(r$tipo =="Correta (significativa)"),`Incorretas p > 0,95`=sum(r$tipo =="Incorreta (significativa)"))}))knitr::kable(tabela)
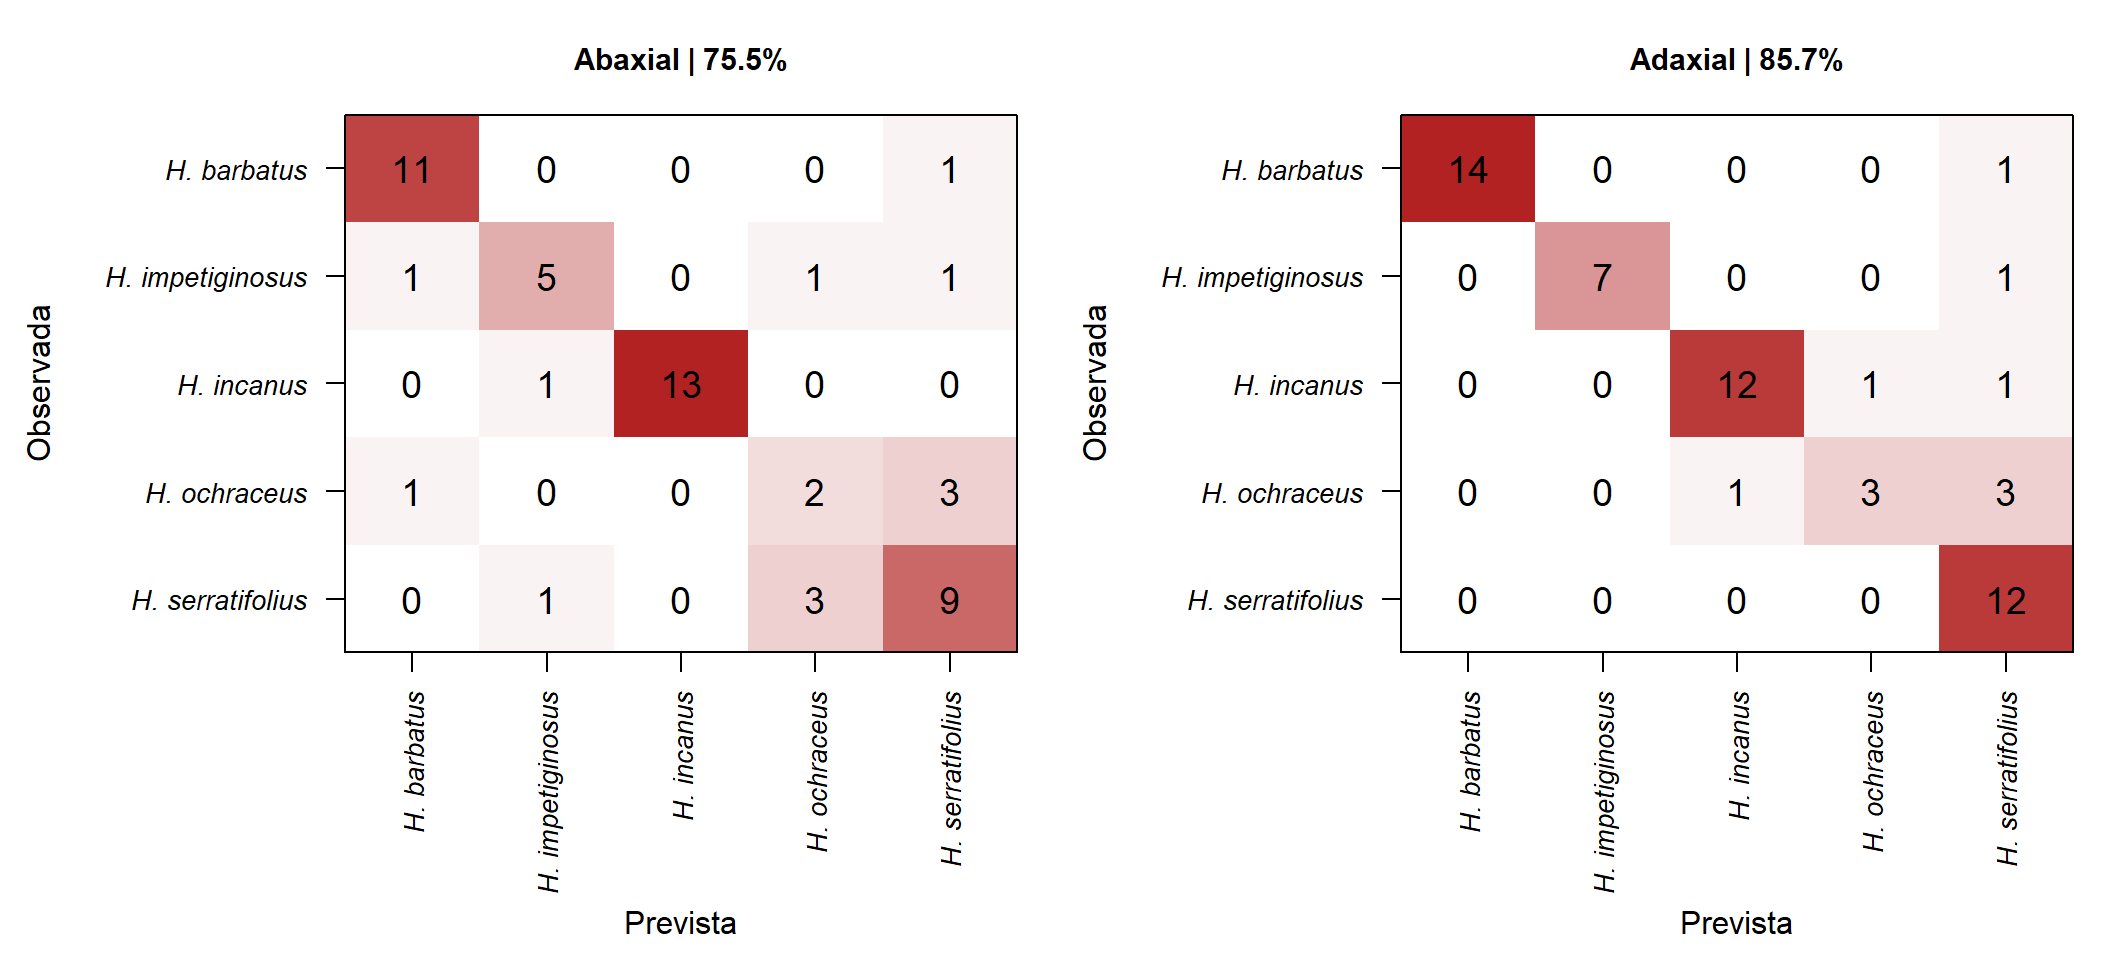
Usando as duas faces juntas, cerca de 88% das exsicatas são classificadas corretamente, contra cerca de 75% só com a face abaxial e 86% só com a adaxial. Combinar as leituras das duas faces dá a melhor discriminação.
Veja também os tipos de previsão: a maior parte dos acertos tem probabilidade alta (> 0,95), e as previsões com probabilidade baixa concentram os erros. Na prática, exsicatas classificadas com baixa probabilidade, ou incorretamente com alta probabilidade, merecem uma revisão da identificação.
Valide sempre no nível da exsicata (ou do indivíduo), nunca da leitura. Se leituras da mesma folha caem no treino e no teste ao mesmo tempo, a acurácia fica inflada.
Com poucas exsicatas por espécie (como H. ochraceus, com 7), os resultados variam bastante. Amostre mais indivíduos sempre que possível.
Para ir além, teste pré-processamentos (SNV, derivadas de Savitzky-Golay, com o pacote prospectr) e outros classificadores (PLS-DA, random forest), sempre com a mesma validação.
Referências
DURGANTE, F. M. et al. 2013. Species spectral signature: discriminating closely related plant species in the Amazon with near-infrared leaf-spectroscopy. Forest Ecology and Management 291: 240-248.
VASCONCELOS, C.; DURGANTE, F. 2025. R codes and datasets used in the course “Herbarium Spectroscopy with MicroNIR: theory and practice” (v1.0.0). Zenodo. https://doi.org/10.5281/zenodo.15531968